

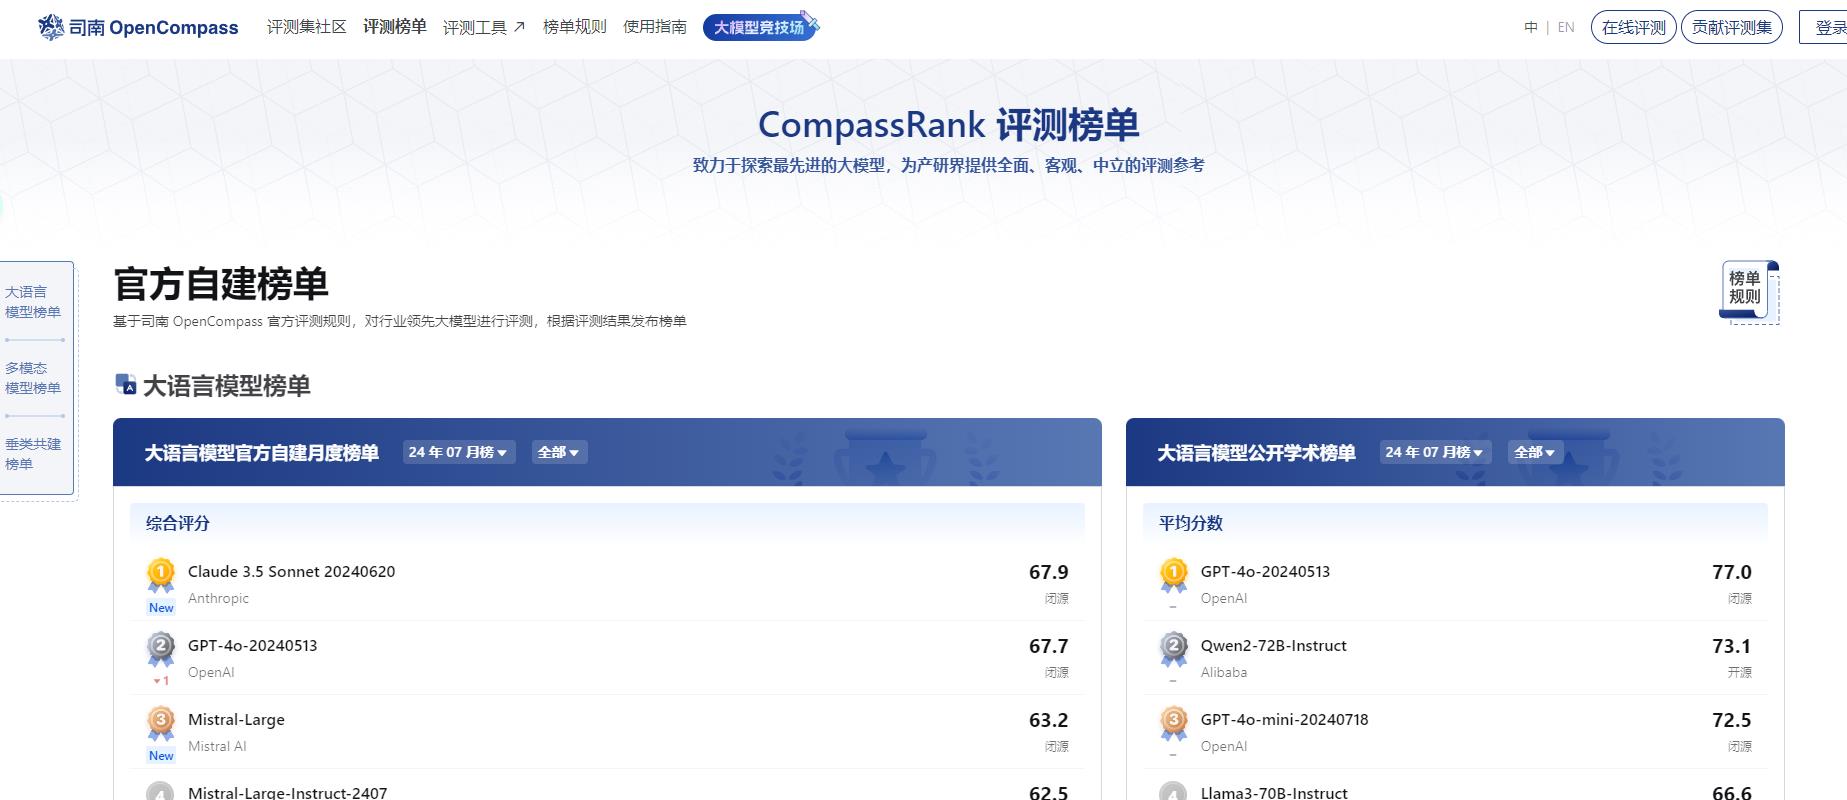
OpenCompass(司南)是由上海人工智能实验室发布的开源大模型评测体系,目前已成为业界权威的大模型评估平台,涵盖学科、语言、知识、理解、推理等评测维度,可全面评估大模型的综合能力。
以下为2024年9月截取的图片,模型排名可能随着日期不同而不同,截图仅供参考,具体以网站内为准:
相关导航


暂无评论...
OpenCompass(司南)是由上海人工智能实验室发布的开源大模型评测体系,目前已成为业界权威的大模型评估平台,涵盖学科、语言、知识、理解、推理等评测维度,可全面评估大模型的综合能力。
以下为2024年9月截取的图片,模型排名可能随着日期不同而不同,截图仅供参考,具体以网站内为准: